断点回归(RDD):局部线性、带宽与操纵检验
断点回归(regression discontinuity design, RDD)利用的是“按门槛分配处理”的规则:分数过线才录取,资产规模过线的企业才能享受某项政策,出生日期决定哪一年入学。只要门槛附近的个体在其他方面差不多,门槛两边结果的跳跃就可以归到处理上。国内最有名的例子大概是淮河供暖线:Chen et al.(2013)以城市到淮河的南北距离作驱动变量,比较线南北两侧的空气污染和预期寿命。
这篇的结果都来自一份模拟数据:驱动变量 在 上均匀分布,断点在 0,真实跳跃是 0.4;断点两侧的曲率方向相反,右侧 附近还有一个平滑的台阶(可以想成另一个政策门槛);样本量 4000。
set seed 20260930
set obs 4000
gen x = runiform(-1, 1)
gen d = (x >= 0)
gen z1 = rnormal()                            // 处理前的协变量
gen y = 0.5 + 0.8*x + cond(x < 0, 1.2, -1.2)*x^2 + 0.6*invlogit(20*(x - 0.7)) ///
        + 0.4*d + 0.2*z1 + 0.3*rnormal()
精确断点识别的是什么
精确断点(sharp RD)里,处理完全由驱动变量决定:。能识别的是断点处的平均处理效应:
关键假设是两个潜在结果的条件期望 、 在断点处连续(Hahn, Todd and Van der Klaauw, 2001)。直观地说,只要个体不能精确地控制自己落在门槛的哪一边,门槛附近谁过线、谁没过线就近似随机(Lee and Lemieux, 2010)。这只是帮助理解的类比,并不等于真的做了随机实验。还有一个容易忽略的条件:同一个门槛上不能同时有别的政策在变。国内不少政策共用同一个企业规模或收入标准,这时断点处的跳跃是几项政策叠在一起的效果。
这个估计量只说明断点处的效应。离门槛很远的个体效应是多少,需要额外的假设才能外推。
估计:带宽内的局部线性
标准做法是在断点两侧各取一个带宽 ,用核加权做局部线性回归,两条回归线在断点处的截距之差就是估计值。以右侧为例:
左侧同理,。核函数常用三角核 ,离断点越近权重越大。
过去很多论文用全样本拟合高阶多项式(三次、四次)来估计跳跃。Gelman and Imbens(2019)专门写文章反对这种做法:全局多项式会给远离断点的观测很大的权重,结果对多项式阶数很敏感,置信区间的覆盖率也差。模拟数据上的对比:
| 方法 | 估计值 | 标准误 |
|---|---|---|
| 全样本线性,两侧斜率各自估计 | 0.659 | 0.023 |
| 全样本四次多项式,两侧系数各自估计 | 0.333 | 0.058 |
局部线性(rdrobust,带宽 0.222) |
0.436 | 0.054 |
| 局部线性,加处理前协变量 | 0.460 | 0.046 |
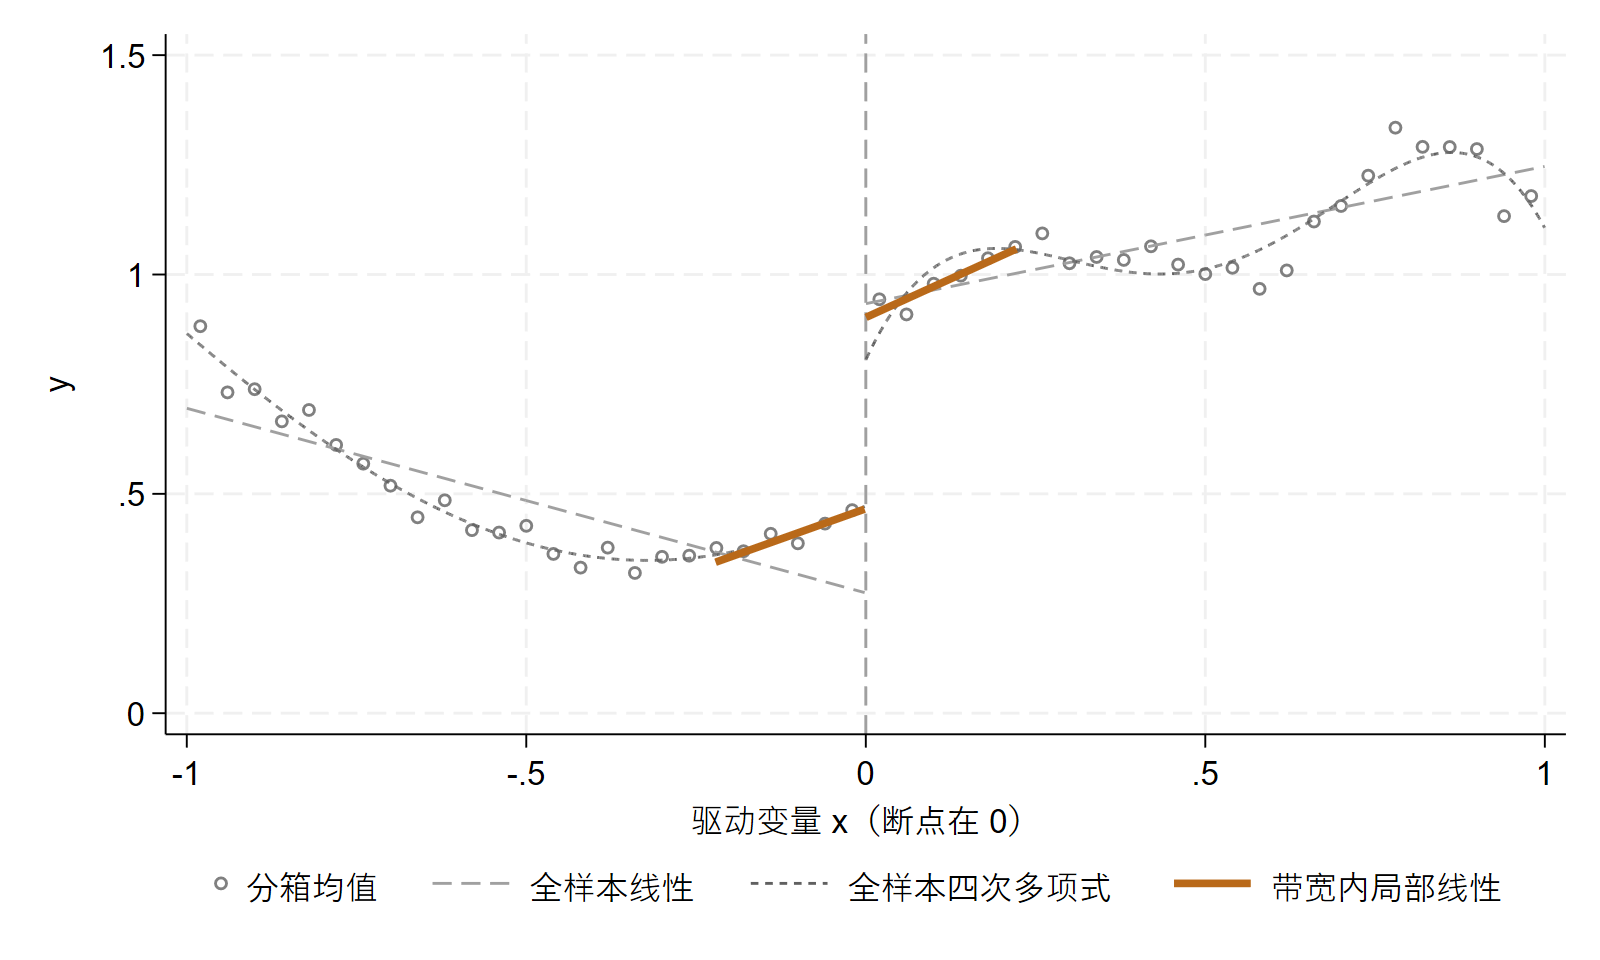
全样本线性的标准误最小、结论最“显著”,但在这个数据生成过程下,它对断点处效应的估计有很大的函数形式偏误,标准误再小也弥补不了。只看一次抽样说明不了太多,所以我把这个数据生成过程重复了 500 次(每次 2000 个观测):
| 方法 | 500 次的平均估计 | 标准差 | 95% 置信区间的实际覆盖率 |
|---|---|---|---|
| 全样本线性 | 0.618 | 0.031 | 0% |
| 全样本四次多项式 | 0.329 | 0.085 | 85.0% |
| 局部线性,常规置信区间 | 0.412 | 0.083 | 90.0% |
| 局部线性,稳健偏差校正置信区间 | — | — | 92.2% |
带宽和稳健置信区间
rdrobust(Calonico et al., 2017)默认用局部线性、三角核,带宽取使均方误差最小的那个(两侧相同,mserd)。这个带宽本来就是在偏差和方差之间折中,所以估计量的偏差和标准误是同一个量级,以点估计为中心的常规置信区间会覆盖不足。Calonico, Cattaneo and Titiunik(2014)的办法是先估计并扣除这部分偏差,再把偏差估计本身的不确定性算进标准误,得到“稳健偏差校正”置信区间。rdrobust 默认输出的点估计是常规估计量,置信区间和 p 值则来自 Robust 那一套推断。要注意这个区间是以偏差校正后的估计为中心的,常规点估计不一定在区间正中间;加 all 选项可以同时看到常规、偏差校正、稳健三行。上面的例子里三者分别是:常规估计 0.436,区间 [0.330, 0.542];偏差校正估计 0.422;稳健区间 [0.297, 0.547],中心正是 0.422。
上面的蒙特卡洛里,常规区间的覆盖率是 90.0%,稳健区间是 92.2%,更接近名义的 95%,代价是区间平均宽一些(0.32 对 0.28)。
带宽要做敏感性分析,常见的是减半和加倍。rdrobust 有两个带宽:估计用的 和估计偏差用的 。只给 h() 不给 b() 时, 会被设成和 相等,所以要缩放就两个一起缩放(默认情况下 ):
| 带宽 () | 估计值 | 稳健 95% 置信区间 |
|---|---|---|
| 0.111(0.187),减半 | 0.447 | [0.265, 0.641] |
| 0.222(0.375),MSE 最优 | 0.436 | [0.297, 0.547] |
| 0.444(0.749),加倍 | 0.476 | [0.348, 0.521] |
带宽越大,用到的观测越多、区间越窄,但离断点远的观测会带进更多曲率造成的偏差;带宽越小则反过来。几种带宽下结论一致,说明结果对带宽的选择不敏感,但这代替不了对识别假设本身的检验。
加处理前的协变量(covs())主要是为了提高精度:只要这些协变量在断点处没有跳跃,加进去不改变估计的对象(Calonico et al., 2019)。上面的例子里,加 后标准误从 0.054 降到 0.046。
有效性检验
操纵检验。 如果个体能精确地把自己挪到门槛上方,门槛两侧的人就不再可比。检验方法是看驱动变量的密度在断点处有没有跳跃(McCrary, 2008),现在常用 rddensity(Cattaneo, Jansson and Ma, 2018),背后的局部多项式密度估计见 Cattaneo, Jansson and Ma(2020)。模拟数据上,密度检验的 ,,没有操纵的迹象。
为了看看操纵会造成什么后果,我另造了一份数据:断点下方 0.1 以内、能力高于平均的人,都把驱动变量挪到断点上方(4000 人里有 89 人这么做),而能力本身会提高 :
clear
set seed 20260930
set obs 4000
gen x0 = runiform(-1, 1)
gen ability = rnormal()
gen manip = (x0 >= -0.1 & x0 < 0) & (ability > 0)
gen x = cond(manip, x0 + 0.1, x0)             // 观测到的是被挪过的 x
gen d = (x >= 0)
gen y = 0.5 + 0.8*x0 + cond(x0 < 0, 1.2, -1.2)*x0^2 + 0.4*d + 0.3*ability + 0.3*rnormal()

rddensity x, c(0)
rdrobust y x, c(0)
rdrobust ability x, c(0)                      // 把能力当结果变量
这时密度检验的 ,;断点回归的估计值变成 0.771,几乎是真实值的两倍;把能力当结果变量做断点回归,它在断点处“跳”了 1.09。这个数可以手算核对:断点下方紧挨着的只剩能力不高于平均的人,能力均值约 ;断点上方是原来的人加上挪过来的人,均值约 0.27,理论上的跳跃约 1.06。
在这个例子里,密度检验和下面的协变量平衡检验都把问题暴露了出来。反过来却不成立:检验不显著,不能证明没有操纵。检验的功效有限,驱动变量离散时效果更差。
协变量平衡。 处理前就决定了的变量在断点处不应该有跳跃,把它们当结果变量跑一遍 rdrobust,这是一种诊断。第一份模拟数据上 的跳跃是 ()。这类检验只能看可观测的变量,不显著也不代表不可观测的因素在断点处连续;检验的变量多了,偶尔有一两个显著也正常,要看整体,报告检验了哪些变量。
安慰剂断点。 在事先选好的、不存在断点的位置假装有断点,不应该出现明显的跳跃。为了不让真断点混进来,只用一侧的数据:左侧假装断点在 ,得到 ();右侧假装在 0.5,得到 0.047()。同样,不显著只说明没检测到跳跃;位置要事先定好,不能试很多个再挑。
甜甜圈检验。 如果有具体理由担心紧挨着门槛的观测有问题(比如有人刚好挪过线,或者取值有堆积),可以去掉断点附近一小段再估计。去掉 的观测后,估计为 0.403,稳健置信区间 [0.219, 0.538]。代价是去掉的恰好是离断点最近、信息最多的观测,估计要往断点处外推一小段,所以它只适合做敏感性分析,并要写清楚去掉的范围和理由。
模糊断点
很多门槛只改变接受处理的概率,并不强制:够资格的不一定申请,不够的也可能通过别的途径拿到。这是模糊断点(fuzzy RD),估计量是结果的跳跃除以处理概率的跳跃:
它本质上就是在断点处、以“是否过线”为工具变量的 2SLS。要识别断点处依从者的平均效应(一个局部的 LATE),需要几个条件同时成立:潜在结果在断点处连续、没有操纵、处理概率确实有跳跃(第一阶段不为零)、越过门槛只通过是否接受处理影响结果(排他性),以及单调性(Hahn, Todd and Van der Klaauw, 2001)。工具变量那边的讨论(依从者、弱工具变量)在这里同样适用,见工具变量那篇。
模拟:越过断点后,接受处理的概率从 0.2 跳到 0.8,真实效应 0.4。
clear
set seed 20260930
set obs 4000
gen x = runiform(-1, 1)
gen above = (x >= 0)
gen d = runiform() < 0.2 + 0.6*above          // 实际是否接受处理
gen y = 0.5 + 0.8*x + cond(x < 0, 1.2, -1.2)*x^2 + 0.4*d + 0.3*rnormal()

rdrobust y x, c(0)                            // 简约式:结果的跳跃
rdrobust d x, c(0)                            // 第一阶段:处理概率的跳跃
rdrobust y x, c(0) fuzzy(d)                   // 模糊断点
单独估计时,结果的跳跃(简约式)是 0.260,处理概率的跳跃(第一阶段)是 0.558,但两者各自选了带宽(0.276 和 0.348),所以相除并不正好等于下面的结果。fuzzy() 用同一个带宽(0.325)同时估计分子和分母,第一阶段是 0.561,模糊断点的估计为 0.461,稳健置信区间 [0.275, 0.557]。
国内论文里常见的问题
- 只用全样本高阶多项式回归,不报告带宽内的局部线性结果。
- 不报告密度检验和协变量平衡检验。
- 驱动变量其实是离散的(按年计的年龄、取整的分数),却当成连续变量处理。断点附近只有少数几个取值时,局部多项式的推断不可靠(Kolesár and Rothe, 2018)。
rdrobust默认的masspoints(adjust)会检查并调整重复取值,但解决不了取值太少的根本问题。 - 断点不止一个(比如各省分数线不同)时,常见做法是把驱动变量换成“到本省分数线的距离”再合在一起估计。这样得到的是各个断点效应的某种加权平均,前提是这些断点可以放在一起比;最好同时报告各个断点各自的估计,或者用专门处理多断点的
rdmulti(Cattaneo, Titiunik and Vazquez-Bare, 2020)。 - 把断点处的效应当成总体平均效应来解释。
代码
* 2026 年 9 月从 SSC 装的 rddensity 缺少 Mata 库,运行时报 file rddensity_fun.do not found;
* 改从作者的 GitHub 安装就没问题
ssc install rdrobust, replace
net install rddensity, from("https://raw.githubusercontent.com/rdpackages/rddensity/master/stata") replace
net install lpdensity, from("https://raw.githubusercontent.com/nppackages/lpdensity/master/stata") replace

* 主估计:局部线性、三角核、MSE 最优带宽;置信区间看 Robust 那一行
rdrobust y x, c(0)
rdrobust y x, c(0) all                        // 同时列出常规、偏差校正、稳健三行
rdrobust y x, c(0) covs(z1)                   // 加处理前协变量
* 数据有真实的聚类结构(比如同一学校的学生)时按聚类变量算标准误;
* 聚类数少时可以换成 vce(cr2 school),但它只是缓解,不是万能的修正
* rdrobust y x, c(0) vce(cluster school)

* 带宽减半、加倍:h 和 b 一起缩放
rdrobust y x, c(0)
scalar h0 = e(h_l)
scalar b0 = e(b_l)
rdrobust y x, c(0) h(`=h0/2') b(`=b0/2')
rdrobust y x, c(0) h(`=h0*2') b(`=b0*2')

* 有效性检验
rddensity x, c(0)                             // 操纵检验
rdrobust z1 x, c(0)                           // 协变量平衡
rdrobust y x if x < 0, c(-0.5)                // 安慰剂断点,只用一侧的数据
rdrobust y x if x >= 0, c(0.5)
rdrobust y x if abs(x) > 0.02, c(0)           // 甜甜圈检验

* 模糊断点:d 是实际是否接受处理(用模糊断点那一节生成的数据)
rdrobust y x, c(0) fuzzy(d)

* 画图:rdplot 默认用全局四次多项式画拟合线,只用来看图,不能当估计结果
rdplot y x, c(0)
上面对比用的全样本回归:
reg y d x c.x#1.d, robust                     // 全样本线性,两侧斜率各自估计
gen x2 = x^2
gen x3 = x^3
gen x4 = x^4
reg y d x x2 x3 x4 c.x#1.d c.x2#1.d c.x3#1.d c.x4#1.d, robust
系统的入门材料推荐 Cattaneo, Idrobo and Titiunik(2020)那本小书,作者里有两位也是 rdrobust 的作者,例子和代码都很全。
参考文献
- Calonico, S., Cattaneo, M. D., & Titiunik, R. (2014). Robust nonparametric confidence intervals for regression-discontinuity designs. Econometrica, 82(6), 2295–2326.
- Calonico, S., Cattaneo, M. D., Farrell, M. H., & Titiunik, R. (2017). rdrobust: Software for regression-discontinuity designs. Stata Journal, 17(2), 372–404.
- Calonico, S., Cattaneo, M. D., Farrell, M. H., & Titiunik, R. (2019). Regression discontinuity designs using covariates. Review of Economics and Statistics, 101(3), 442–451.
- Cattaneo, M. D., Idrobo, N., & Titiunik, R. (2020). A Practical Introduction to Regression Discontinuity Designs: Foundations. Cambridge University Press.
- Cattaneo, M. D., Jansson, M., & Ma, X. (2018). Manipulation testing based on density discontinuity. Stata Journal, 18(1), 234–261.
- Cattaneo, M. D., Jansson, M., & Ma, X. (2020). Simple local polynomial density estimators. Journal of the American Statistical Association, 115(531), 1449–1455.
- Cattaneo, M. D., Titiunik, R., & Vazquez-Bare, G. (2020). Analysis of regression-discontinuity designs with multiple cutoffs or multiple scores. Stata Journal, 20(4), 866–891.
- Chen, Y., Ebenstein, A., Greenstone, M., & Li, H. (2013). Evidence on the impact of sustained exposure to air pollution on life expectancy from China's Huai River policy. Proceedings of the National Academy of Sciences, 110(32), 12936–12941.
- Gelman, A., & Imbens, G. (2019). Why high-order polynomials should not be used in regression discontinuity designs. Journal of Business & Economic Statistics, 37(3), 447–456.
- Hahn, J., Todd, P., & Van der Klaauw, W. (2001). Identification and estimation of treatment effects with a regression-discontinuity design. Econometrica, 69(1), 201–209.
- Kolesár, M., & Rothe, C. (2018). Inference in regression discontinuity designs with a discrete running variable. American Economic Review, 108(8), 2277–2304.
- Lee, D. S., & Lemieux, T. (2010). Regression discontinuity designs in economics. Journal of Economic Literature, 48(2), 281–355.
- McCrary, J. (2008). Manipulation of the running variable in the regression discontinuity design: A density test. Journal of Econometrics, 142(2), 698–714.