倾向得分匹配(PSM):平衡、标准误与 PSM-DID 的陷阱
倾向得分匹配(propensity score matching, PSM)在国内实证论文里出场频率很高,常见的角色是“缓解样本选择偏误”的稳健性检验,或者和 DID 连用成 PSM-DID。这篇把它能做什么、不能做什么分开记。
识别靠的是什么
用潜在结果来写,关心的通常是处理组的平均处理效应(ATT):
匹配能识别它,靠两个假设:
- 条件独立(selection on observables):给定可观测的特征 ,是否受处理和潜在结果无关,(估 ATT 只需要对 成立)。
- 共同支撑(overlap):在处理组企业的特征范围内,受处理的概率要小于 1(估 ATE 的话还要大于 0),这样每个处理组企业在理论上都有可比的对照。样本里能不能真的找到,要另外检查。
倾向得分是给定特征时受处理的概率 。Rosenbaum and Rubin(1983)证明,如果给定 条件独立成立,那么给定真实的 也成立。所以不用在一堆特征上逐个匹配,只要在一个一维的得分上匹配。注意这是对真实倾向得分说的;实际用的是估出来的得分,模型可能设错,匹配后还得逐个变量检查平衡。
这里要先说清楚:PSM 和“回归里加控制变量”都依赖“选择只取决于可观测变量”,谁也处理不了看不见的混杂。两者的区别在函数形式、权重、对外推的依赖程度,以及估计的目标(ATT 还是 ATE),而不在于能不能处理内生性。
模拟:处理概率非线性、效应因企业而异
4000 家企业,是否受处理取决于规模 (含平方项)、杠杆 和是否国企 ;处理效应随规模变大:
set seed 20261003
set obs 4000
gen x1 = rnormal()                           // 规模(标准化)
gen x2 = rnormal()                           // 杠杆(标准化)
gen x3 = runiform() < 0.4                    // 是否国企
gen ps = invlogit(-1 + 0.8*x1 + 0.4*x1^2 - 0.5*x2 + 0.6*x3)
gen d = runiform() < ps
gen tau = 1 + 0.5*x1                         // 处理效应,规模越大越强
gen y = 1 + 1.0*x1 + 0.5*x1^2 - 0.8*x2 + 0.5*x3 + tau*d + rnormal()
gen x1sq = x1^2
1666 家受处理。受处理的企业规模偏大,所以 ATT 比 ATE 高:样本里真实的 ATT 是 1.192(总体是 1.184),ATE 是 1.0。
各方法的估计值(真实 ATT 是 1.192;前两行本来就不是 ATT 的估计量,列在这里作对照):
| 方法 | 估计值 | 标准误 |
|---|---|---|
| 直接比较两组均值 | 2.437 | 0.065 |
| OLS,线性控制 、、 | 1.334 | 0.043 |
psmatch2,1 个近邻(有放回),线性 logit |
1.323 | 0.096 |
psmatch2,logit 加 的平方项 |
1.131 | 0.097 |
teffects psmatch,线性 logit |
1.347 | 0.070 |
teffects psmatch,logit 加 的平方项 |
1.161 | 0.054 |
teffects ipw(加平方项) |
1.190 | 0.135 |
teffects ipwra(加平方项) |
1.148 | 0.043 |
几点:
- 直接比均值严重高估,因为规模大的企业既更容易受处理、结果又更高。
- OLS 的 1.334 也偏了,原因有两层:一是回归里漏掉了结果方程中的 ,而 又影响是否受处理,这是遗漏变量偏误;二是处理效应因企业而异,即使函数形式设对,线性回归的处理变量系数也是各企业效应的某种加权平均,不等于 ATT。
- 倾向得分模型设错了(漏掉平方项),匹配也好不到哪里去(1.32–1.35)。模型设对之后,匹配、逆概率加权(IPW)和加权回归调整(IPWRA)都回到 1.13–1.19 附近。
psmatch2和teffects的结果不完全一样(线性 logit 下 1.323 对 1.347),因为两者并不是同一个估计量:这里psmatch2加了common,去掉了共同支撑之外的处理组,teffects没有;两者处理并列得分的方式也不同。要比较,就得把样本、近邻个数、是否放回、卡尺都统一。
平衡性:看标准化差异和方差比
倾向得分模型设得好不好,至少要看匹配后两组的可观测特征是否平衡。平衡是必要的诊断,但它证明不了没有遗漏的混杂。tebalance summarize 报告标准化差异(两组均值之差除以合并标准差)和方差比:
| 变量 | 匹配前 | 匹配后(线性 logit) | 匹配后(加平方项) |
|---|---|---|---|
| 标准化差异 | 0.633 | 0.099 | |
| 方差比 | 1.648 | 1.282 | 0.934 |
| 标准化差异 | 0.386 | 0.208 | |
| 标准化差异 | 0.070 | ||
| 标准化差异 | 0.257 | 0.043 |
只用线性 logit 时, 的均值差不多配上了,但方差比还有 1.28, 的标准化差异 0.21,说明这几个矩还没配平;加上平方项后,这两项都好了。检查平衡时不能只看均值,高次项和交互项也要看,最好再把两组的分布画出来对照。
另一方面,加了平方项后 的标准化差异反而到了 :单近邻匹配的平衡本身波动很大,实际做的时候要继续调整(多个近邻、卡尺、换匹配方法),每调一次都重新检查。
常用的经验标准是标准化差异的绝对值小于 0.1、方差比接近 1(Austin, 2011),它们只是经验规则,不是识别成立的证明。平衡以标准化差异、方差比和分布图为主,不要拿 t 检验当主要标准:t 检验的 p 值会随样本量变,匹配后样本变小,p 值自然变大,并不代表更平衡了(Imai, King and Stuart, 2008)。psmatch2(Leuven and Sianesi, 2003)配套的 pstest 也报告标准化偏差(%bias,就是标准化差异乘以 100)。
共同支撑
先把两组的倾向得分分布画出来(teffects overlap, ptlevel(1);不加 ptlevel(1) 的话,它默认画的是第一个处理水平,也就是不受处理的概率)。这份数据里,处理组的得分在 0.087 到 0.997 之间,对照组在 0.060 到 0.975 之间,重叠得还可以。
修剪有两种常见规则,不要混为一谈:一是 Crump et al.(2009)的经验规则,去掉得分落在 [0.1, 0.9] 之外的观测,这里有 147 个;二是 psmatch2 的 common 选项,只去掉得分高于对照组最大值、或低于对照组最小值的处理组,这里去掉了 24 家。修剪之后估计的就是“有重叠的那部分企业”的效应,用了哪种规则、去掉了谁、估计的对象变成了什么,报告时都要说清楚。
标准误
最近邻匹配估计量的大样本性质(包括它的偏差和方差)见 Abadie and Imbens(2006)。psmatch2 默认的标准误,按它的帮助文件,是在“观测相互独立、匹配权重固定、两组内同方差”的假设下算的近似公式:同一个对照企业被重复使用,体现在公式里权重的平方和上;它没有考虑的是倾向得分本身是估出来的。用 bootstrap 也不行:最近邻匹配估计量的 bootstrap 标准误一般不一致(Abadie and Imbens, 2008)。teffects psmatch 报告的是 Abadie and Imbens(2016)的标准误,考虑了倾向得分的估计误差。
一个小的蒙特卡洛(200 次,每次 2000 家企业,倾向得分模型设对):
| 平均估计 | 估计值的实际标准差 | 报告标准误的平均 | 95% 置信区间覆盖率 | |
|---|---|---|---|---|
psmatch2 |
1.227 | 0.097 | 0.146 | 98.5% |
teffects psmatch |
1.227 | 0.097 | 0.093 | 91.0% |
两者点估计完全一样,差别只在标准误。这里 psmatch2 的标准误偏大、过于保守;它是在一组简化假设下的近似,不考虑倾向得分的估计误差,偏大还是偏小取决于数据,不能指望它总是保守。teffects 的标准误和实际波动很接近,覆盖率略低于 95%,主要是因为单近邻匹配本身有一点偏差:平均估计 1.227,真实 ATT 1.184。这只是一次模拟的结果。我的做法是用 teffects 做匹配,报告与这个估计量对应的 Abadie–Imbens 标准误。
PSM 解决不了的问题
在同一个数据生成过程里加一个观测不到的变量 ,让它同时影响是否受处理和结果:
gen u = rnormal()
replace d = runiform() < invlogit(-1 + 0.8*x1 + 0.4*x1^2 - 0.5*x2 + 0.6*x3 + 1.0*u)
replace y = 1 + 1.0*x1 + 0.5*x1^2 - 0.8*x2 + 0.5*x3 + 0.8*u + tau*d + rnormal()
teffects psmatch (y) (d c.x1##c.x1 x2 x3, logit), atet
倾向得分模型的写法和前面完全一样,估计变成 1.783,真实 ATT 是 1.179。(严格地说,漏掉 以后,只用 表示的受处理概率也不再是这个 logit 形式了。)PSM 只能平衡看得见的变量;审稿人担心的如果是遗漏变量或反向因果,PSM 回答不了,要么换识别策略,要么做敏感性分析,看遗漏变量要多强才能推翻结论。
还有一个值得知道的批评:King and Nielsen(2019)指出,在倾向得分上匹配,越是把样本“修剪”得精细,协变量的不平衡和模型依赖有时反而越严重,他们建议改用马氏距离匹配等方法。不管用哪种,最后都要回到平衡性检查上。
PSM-DID 的一个陷阱
国内常见的 PSM-DID,是先用政策前的特征给处理组找对照,再在匹配后的样本上做 DID。这个思路来自 Heckman, Ichimura and Todd(1997)的“差分匹配”。问题出在匹配变量上:如果拿政策前的结果(或者和结果高度相关、又带着偶然波动的变量)去匹配,而处理组和对照组的长期水平本来就不同,匹配就会挑出那些“政策前刚好运气不好”的对照企业,它们在政策后会回到自己原来的水平,均值回归就被当成了政策效应(Daw and Hatfield, 2018)。
模拟:2000 家企业,2010–2019 年,前 400 家在 2015 年受政策影响,真实效应为 0。处理企业的长期水平平均低 1,但两组趋势平行,所以全样本 DID 本来没有问题:
clear
set seed 20261006
set obs 2000
gen id = _n
gen treat = (id <= 400)
gen alpha = rnormal() - treat                 // 处理企业的长期水平平均低 1
expand 10
bysort id: gen year = 2009 + _n
gen y = alpha + 0.1*(year - 2010) + rnormal() // 真实政策效应为 0
gen post = (year >= 2015)
gen did = treat*post
reghdfe y did, absorb(id year) vce(cluster id)                // 全样本

* 按政策前五年结果的均值做一对一、不放回的匹配
bysort id: egen ypre = mean(cond(year < 2015, y, .))
preserve
keep if year == 2014
set seed 2026
gen u = runiform()
sort u                                        // 不放回匹配前先随机排序
psmatch2 treat ypre, logit neighbor(1) noreplacement
keep if _weight == 1                          // 匹配上的处理组和对照组
keep id
save psm_ids, replace
restore
merge m:1 id using psm_ids, keep(match) nogen
reghdfe y did, absorb(id year) vce(cluster id)                // 匹配后
全样本 DID 估计为 (),没有问题。匹配后的 400 对企业上,DID 变成 (标准误 0.045,),一个“显著的负效应”凭空出现了。这个 p 值是在给定匹配样本的条件下算的,没有考虑匹配这一步本身的不确定性,这里只是拿它说明问题。原因可以直接看到:匹配上的对照企业,长期水平的均值是 ,处理企业是 ,对照企业只是政策前那几年偏低而已。
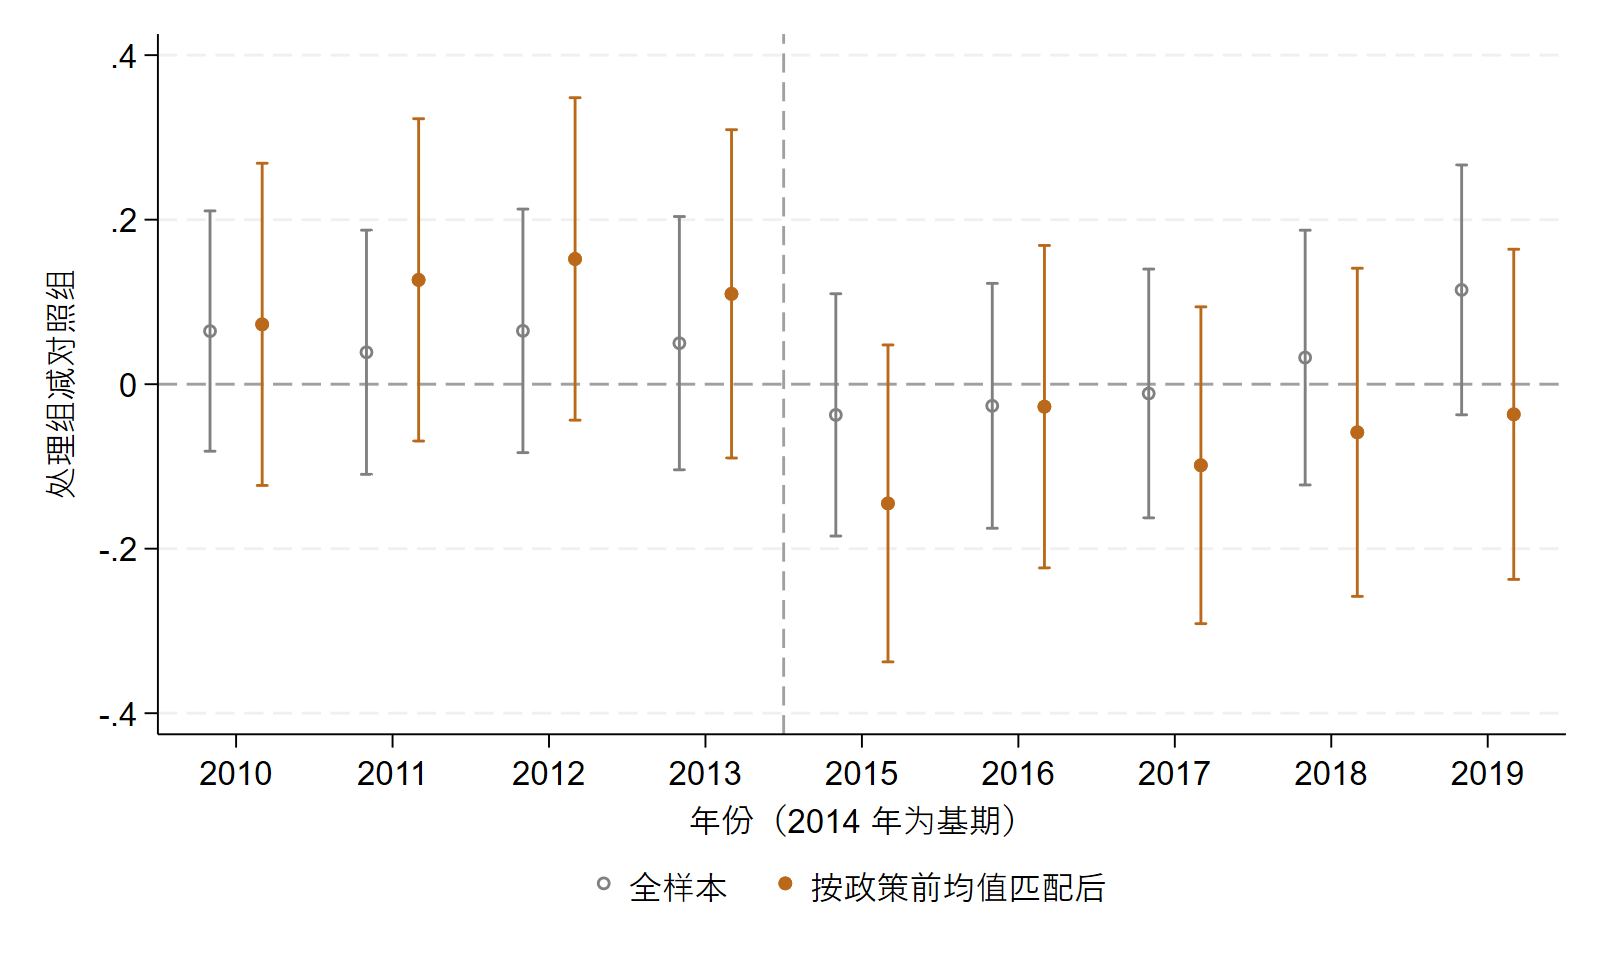
图里的事件研究,是把 did 换成各年份的虚拟变量(2014 年为基期),分别在全样本和匹配后的样本上估计,做法同 DID 上篇。
最麻烦的是,匹配把政策前“配平”了,事件研究图的政策前部分看不出异常。几点做法:
- 两组长期水平不同,本来就是 DID 能处理的,不需要靠匹配把水平配齐。
- 处理组和对照组长期水平不同、政策前的结果又带偶然波动时,拿政策前结果(或者波动大的财务指标)去匹配就有均值回归的风险。政策前结果本身是很重要的协变量,用不用、怎么用(比如看多期的走势而不是单年的水平),要结合这些情况判断,并说明理由。
- 全样本 DID 和匹配后的 DID 都报告;两者差得多时,要想想是不是均值回归。
- 逐年重新匹配会让每年的样本都不一样,估计的对象说不清楚,也尽量避免。
代码
ssc install psmatch2, replace

* psmatch2:默认用 probit,加 logit 改用 logit;neighbor(1) 是 1 个近邻,默认有放回
* (同一个对照可以被多次使用);common 去掉共同支撑之外的处理组
psmatch2 d x1 x1sq x2 x3, outcome(y) logit neighbor(1) common
pstest x1 x1sq x2 x3, both                    // 匹配前后的标准化偏差

* Stata 自带的 teffects:标准误考虑了倾向得分是估出来的
teffects psmatch (y) (d c.x1##c.x1 x2 x3, logit), atet
tebalance summarize                           // 标准化差异和方差比
teffects overlap, ptlevel(1)                  // 两组受处理概率的分布
teffects ipw (y) (d c.x1##c.x1 x2 x3, logit), atet
teffects ipwra (y c.x1##c.x1 x2 x3) (d c.x1##c.x1 x2 x3, logit), atet
入门可以看 Caliendo and Kopeinig(2008),从选匹配方法到检查平衡都有具体建议;Imbens and Wooldridge(2009)是更全面的综述。
参考文献
- Abadie, A., & Imbens, G. W. (2006). Large sample properties of matching estimators for average treatment effects. Econometrica, 74(1), 235–267.
- Abadie, A., & Imbens, G. W. (2008). On the failure of the bootstrap for matching estimators. Econometrica, 76(6), 1537–1557.
- Abadie, A., & Imbens, G. W. (2016). Matching on the estimated propensity score. Econometrica, 84(2), 781–807.
- Austin, P. C. (2011). An introduction to propensity score methods for reducing the effects of confounding in observational studies. Multivariate Behavioral Research, 46(3), 399–424.
- Caliendo, M., & Kopeinig, S. (2008). Some practical guidance for the implementation of propensity score matching. Journal of Economic Surveys, 22(1), 31–72.
- Crump, R. K., Hotz, V. J., Imbens, G. W., & Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199.
- Daw, J. R., & Hatfield, L. A. (2018). Matching and regression to the mean in difference-in-differences analysis. Health Services Research, 53(6), 4138–4156.
- Heckman, J. J., Ichimura, H., & Todd, P. E. (1997). Matching as an econometric evaluation estimator: Evidence from evaluating a job training programme. Review of Economic Studies, 64(4), 605–654.
- Imai, K., King, G., & Stuart, E. A. (2008). Misunderstandings between experimentalists and observationalists about causal inference. Journal of the Royal Statistical Society: Series A, 171(2), 481–502.
- Imbens, G. W., & Wooldridge, J. M. (2009). Recent developments in the econometrics of program evaluation. Journal of Economic Literature, 47(1), 5–86.
- King, G., & Nielsen, R. (2019). Why propensity scores should not be used for matching. Political Analysis, 27(4), 435–454.
- Leuven, E., & Sianesi, B. (2003). PSMATCH2: Stata module to perform full Mahalanobis and propensity score matching, common support graphing, and covariate imbalance testing. Statistical Software Components S432001, Boston College.
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55.