双重差分(上):从 2×2 到事件研究
双重差分(difference-in-differences, DID)大概是实证论文里出现最多的识别策略。这一篇只讲所有处理组在同一年受政策影响的情形:先把 2×2 的逻辑写清楚,再讲面板里的双向固定效应和事件研究。政策分批实施(交错 DID)的问题放在下一篇。
文中的回归结果都来自一份模拟数据:500 家企业,2010–2021 年,前 200 家在 2017 年受到政策冲击,效应第一年是 0.5,之后每年增加 0.25。真实数据不知道答案,模拟数据的好处是可以对答案。
2×2:两组、两期
用潜在结果来写: 和 分别是个体 在 期受政策影响和不受影响时的结果, 表示处理组, 表示政策前后。我们要的是处理组在政策后的平均处理效应(ATT):
难点在 :处理组如果没受政策影响会怎样,观测不到。DID 用对照组的变化来补:
这就是平行趋势假设。再加上“政策前没有预期效应”(处理组在 观测到的就是 ),就得到
对应的回归是
和用四个样本均值算出来的双重差分完全相等。
几个容易想岔的地方:
- 平行趋势说的是反事实,没法直接检验。政策前两组走势平行只是支持它的证据,不是证明。
- DID 允许两组的水平不同,组间固定的差异会被差分掉;它不允许两组因为政策以外的原因走出不同的趋势。
- 平行趋势和函数形式有关:对 平行和对 平行,一般不会同时成立(Roth and Sant'Anna, 2023)。用水平值还是对数,不只是稳健性检验的问题。
面板里的写法:双向固定效应
面板数据里通常写成
个体固定效应 吸收了 ,年份固定效应 吸收了 ,回归里只剩交乘项。所有处理组同一年受政策影响时, 就是标准的 DID 估计量。
global controls "size lev roa"      // 控制变量,按自己的数据改
gen did = treat*post
reghdfe y did $controls, absorb(id year) vce(cluster id)

* 等价写法,不用单独生成交乘项
reghdfe y c.treat#c.post $controls, absorb(id year) vce(cluster id)
模拟数据上得到 (标准误 0.077)。真实效应在 2017–2021 年依次是 0.5、0.75、1.0、1.25、1.5,平均正好是 1.0。可见效应随时间变化时,静态 DID 给出的是政策后各年效应的平均;只有一个处理时点、面板平衡时,这个平均是等权的。
还有两个细节。
控制变量不能被政策本身影响。 如果某个控制变量会被政策改变(比如政策影响了企业杠杆,杠杆又被放进回归),它会吃掉一部分政策效应,也就是所谓的“坏控制”(bad control)。随时间变化的控制变量只要不受政策影响,照样可以放。拿不准的时候,一个稳妥的做法是用政策前某一年的取值和年份虚拟变量交乘,允许不同特征的企业有不同的时间趋势。这本身也是一种设定,等于假定这些特征只通过“各年的趋势不同”起作用:
* 用 2016 年(政策前一年)的规模与年份交乘
bysort id: egen size0 = max(cond(year == 2016, size, .))
reghdfe y did c.size0#i.year, absorb(id year) vce(cluster id)
标准误至少聚类到政策分配的层级。 DID 面板里误差项往往有很强的序列相关,处理变量本身又非常持久(政策前一直是 0,政策后一直是 1),两者叠在一起,不聚类的标准误会严重偏小(Bertrand, Duflo and Mullainathan, 2004)。政策落在城市层面,就按城市聚类。聚类数太少、或者存在跨地区的相关时,还要另外处理,细节写在另一篇。
事件研究:把平均效应拆到每一年
事件研究(event study)把 换成一组“相对政策年份”的虚拟变量:
是个体 受政策影响的年份,从未受影响的个体这些虚拟变量全为 0。(政策前一年)是基期,所以每个 都是“相对于政策前一年,处理组比对照组多出来的部分”。 的系数用来看政策前有没有趋势差异, 的系数是逐年的动态效应。
gen treat_year = 2017 if treat == 1      // 对照组保持缺失
gen rel = year - treat_year
replace rel = -5 if rel < -5             // 太远的期数合并(首尾合并)
replace rel = 5 if rel > 5 & rel != .    // 注意这里的 rel != .
forvalues k = 5(-1)2 {
    gen pre_`k' = (rel == -`k')
}
gen current = (rel == 0)
forvalues k = 1/4 {                      // 本例数据到 2021 年,政策后最多 4 期
    gen post_`k' = (rel == `k')
}
reghdfe y pre_* current post_* $controls, absorb(id year) vce(cluster id)

coefplot, keep(pre_* current post_*) vertical yline(0) xline(4.5, lpattern(dash)) ///
    coeflabels(pre_5="≤-5" pre_4="-4" pre_3="-3" pre_2="-2" current="0"          ///
               post_1="1" post_2="2" post_3="3" post_4="4")                     ///
    ciopts(recast(rcap)) xtitle("相对政策实施的年份") ytitle("估计系数")
Stata 里有个坑:缺失值比任何数都大。rel > 5 对对照组(rel 缺失)也成立,不加 & rel != . 就会把对照组全部改成 5,事件研究直接错掉。rel < -5 没有这个问题。
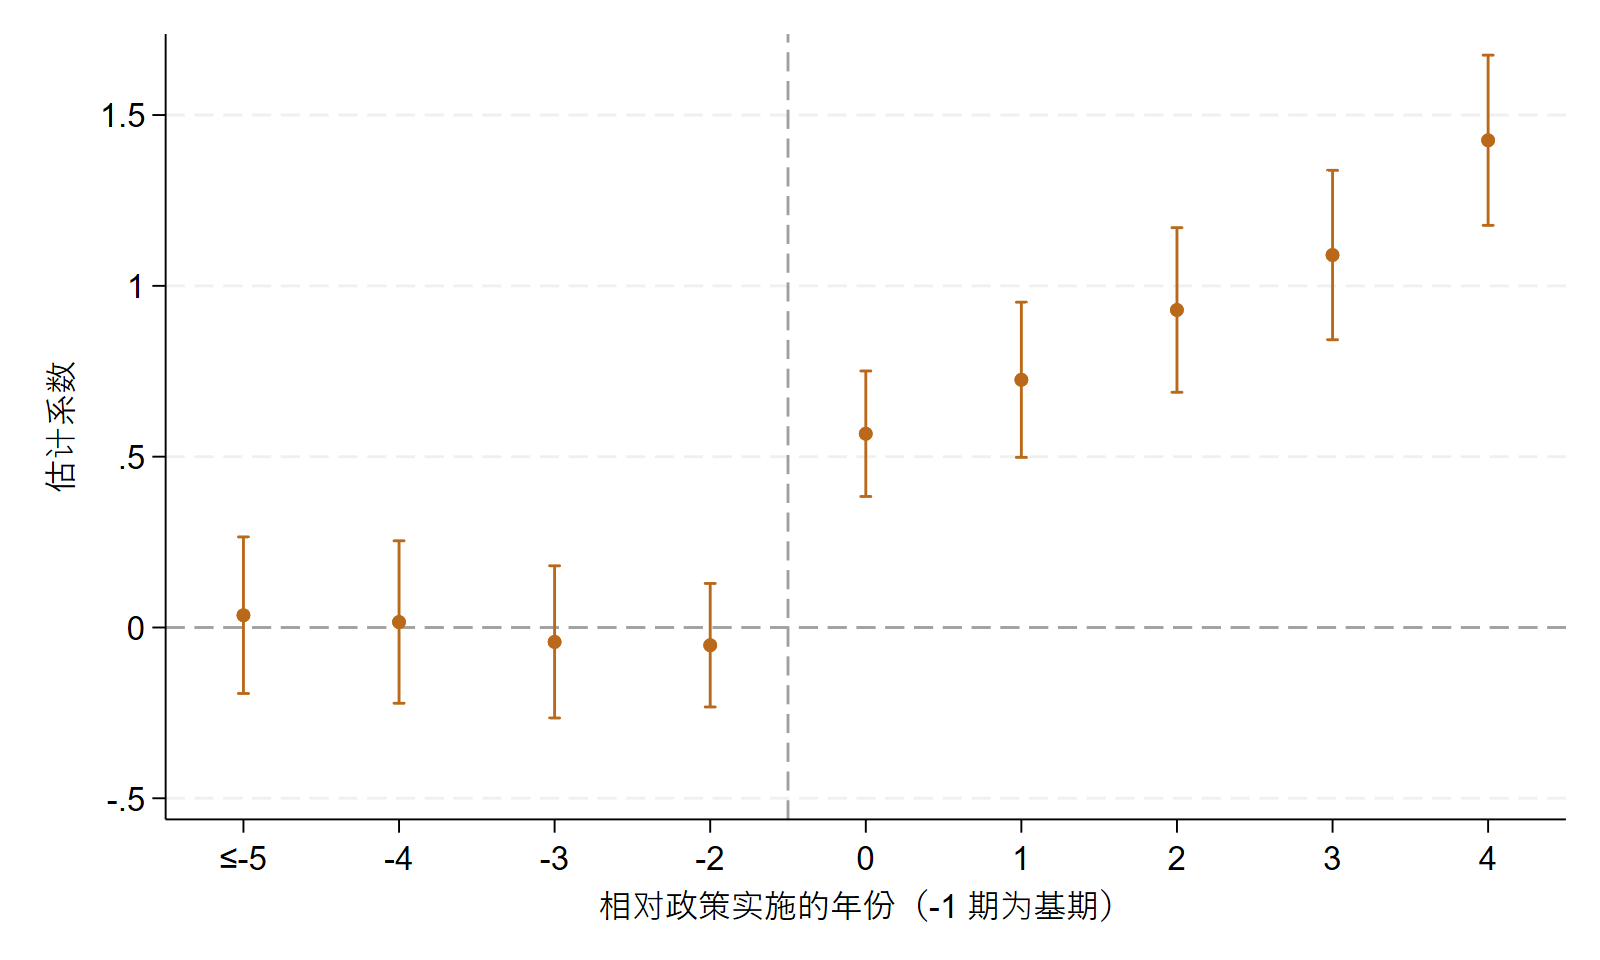
关于政策前系数的检验,有两个提醒:
- 检验力可能很低。 政策前系数不显著,也可能只是标准误太大,不代表趋势真的平行。Roth(2022)还指出,以“通过了预趋势检验”为前提再报告结果,这个筛选本身就会让估计多出一层偏差。
- 可以做敏感性分析。 Rambachan and Roth(2023)的一种做法是:假定政策后偏离平行趋势的幅度,不超过政策前观察到的最大偏离的 倍,看 放到多大时结论还成立。R 有 HonestDiD 包,Stata 有对应的
honestdid命令。
有些论文看到政策前有趋势,就加上个体特定的线性时间趋势(absorb(id##c.year))。这要小心:如果政策效应本身随时间增长,线性趋势会把一部分效应也吸收掉。在上面的模拟数据上,加了这一项之后,估计值从 0.943 掉到 0.705,而真实的平均效应是 1.0。
安慰剂检验的两种做法
一是虚构政策时间。 只保留政策前的样本,假装政策提前几年发生,估出来的“效应”应该不显著:
preserve
keep if year < 2017
gen fake_did = treat*(year >= 2014)
reghdfe y fake_did $controls, absorb(id year) vce(cluster id)
restore
模拟数据上得到 ()。
二是随机指定处理组。 从全部个体里随机抽出与真实处理组同样多的个体当作“伪处理组”,重复几百次,看伪估计值的分布:
set seed 2026
tempfile placebo
tempname sim
postfile `sim' b using `placebo', replace
forvalues r = 1/500 {
    preserve
    bysort id: gen u = runiform() if _n == 1    // 每个个体抽一个随机数
    bysort id (u): replace u = u[1]
    egen rk = group(u)                           // 按随机数给个体排序
    gen fake_did = (rk <= 200)*post              // 前 200 个当伪处理组
    quietly reghdfe y fake_did $controls, absorb(id year) vce(cluster id)
    post `sim' (_b[fake_did])
    restore
}
postclose `sim'
use `placebo', clear
summarize b, detail
500 次伪估计的均值是 ,没有一次的绝对值超过真实估计 0.943。
这两种检验回答的问题不一样。第二种是置换式的安慰剂检验:在同样的数据结构下,随便指定一组“处理组”,能不能也估出这么大的系数。它帮助判断结果是不是偶然,但观测数据里处理并不是真的随机分配的,所以它不是严格意义上的随机化推断;它更检验不了“处理组本来就和对照组走得不一样”。平行趋势还是要靠事件研究图和对政策背景的论证。
写之前过一遍的清单
- 所有处理组是不是同一年受政策影响?不是的话看下一篇。
- 处理组是不是只有一个地区?只有一个的话,DID 很难找到平行的对照组,看合成控制法那篇。
- 政策前有没有预期效应?政策公布和实施之间隔了多久?
- 标准误的聚类层级是否不低于政策分配的层级?
- 控制变量会不会被政策影响?
- 事件研究图:基期是哪一期,远端是否合并,置信区间是多少。
- 同期有没有别的政策也作用在处理组上?
参考文献
- Angrist, J. D., & Pischke, J.-S. (2009). Mostly Harmless Econometrics: An Empiricist's Companion. Princeton University Press.
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? Quarterly Journal of Economics, 119(1), 249–275.
- Cunningham, S. (2021). Causal Inference: The Mixtape. Yale University Press.
- Rambachan, A., & Roth, J. (2023). A more credible approach to parallel trends. Review of Economic Studies, 90(5), 2555–2591.
- Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322.
- Roth, J., & Sant'Anna, P. H. C. (2023). When is parallel trends sensitive to functional form? Econometrica, 91(2), 737–747.
- Roth, J., Sant'Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What's trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244.