双重差分(下):交错处理与新估计量
上一篇假设所有处理组在同一年受政策影响。现实里更常见的是分批试点:一批城市 2013 年进入,一批 2016 年进入,还有的一直没进入。这种交错处理(staggered adoption)的 DID,过去几乎都用同一个双向固定效应(TWFE)回归来估计。2018 年前后的一批计量文献说明,只要处理效应随时间或批次变化,这个回归就可能给出很离谱的答案。
先看一个例子
模拟数据:1000 个个体,2010–2021 年。三批个体分别在 2013、2016、2019 年进入处理,每批 250 个,另有 250 个从未处理。处理效应随处理时长增长,而且越早进入的批次增长越快:
每一个真实效应都是正的,全部处理观测的平均效应(ATT)是 1.325。
set seed 20260925
set obs 1000
gen id = _n
gen g = cond(id <= 250, 2013, cond(id <= 500, 2016, cond(id <= 750, 2019, .)))
gen s = cond(g == 2013, 0.4, cond(g == 2016, 0.25, cond(g == 2019, 0.1, 0)))
gen alpha = rnormal()
expand 12
bysort id: gen year = 2009 + _n
gen e = rnormal()
gen k = year - g                        // 从未处理的个体为缺失
gen D = (k >= 0 & k != .)
gen tau = cond(D, s*(k + 1), 0)
gen y = alpha + 0.1*(year - 2010) + tau + e

reghdfe y D, absorb(id year) vce(cluster id)
TWFE 估计为 0.508(标准误 0.040),不到真实值的四成。把这个模拟重复 200 次,TWFE 估计值的平均是 0.460,所以这不是运气不好,而是系统性的偏差。
偏差从哪里来:Goodman-Bacon 分解
Goodman-Bacon(2021)证明,交错处理下的 TWFE 估计量是所有“2×2 DID”的加权平均。这些 2×2 比较分三类:
- 处理组对比从未处理组;
- 早处理组对比晚处理组,只用晚处理组还没受处理的年份;
- 晚处理组对比早处理组,用的是早处理组已经受处理之后的年份,把早处理组当对照。
问题出在第 3 类。早处理组这时的效应还在增长,拿它当“对照”,等于从晚处理组的效应里减掉早处理组效应的增量。效应增长得越快,这一项越可能是负的。
bacondecomp 可以把 TWFE 估计值拆开,要求强平衡面板、处理一旦开始就不退出:
xtset id year
bacondecomp y D, ddetail
模拟数据的分解结果,按比较类型汇总:
| 比较类型 | 权重 | 2×2 估计值(加权平均) |
|---|---|---|
| 处理组对比从未处理组 | 0.50 | 1.10 |
| 早处理组对比晚处理组(晚的还没处理) | 0.25 | 0.90 |
| 晚处理组对比早处理组(早的已经处理) | 0.25 | −1.08 |
| 合计,即 TWFE 估计值 | 1.00 | 0.51 |
四分之一的权重落在了估计值为 −1.08 的比较上,尽管每一个真实效应都是正的。另外,即便是第 1 类“干净”的比较,权重也取决于各批次的样本量和处理时点在样本期里的位置(大致是处理变量的方差),而不是按处理观测的个数分配,所以它的 1.10 也不等于我们要的 1.325。
de Chaisemartin and D'Haultfœuille(2020)从另一个角度得到了类似的结论:TWFE 系数是各组各期处理效应的加权和,其中一部分权重可以是负的。
事件研究也会被污染
把静态的 换成一串相对时间虚拟变量,能不能躲开这个问题?Sun and Abraham(2021)说明,只要不同批次在同一相对时间上的效应不一样,TWFE 事件研究的某个系数就会混进其他相对时期的效应。最麻烦的是它会污染政策前的系数。
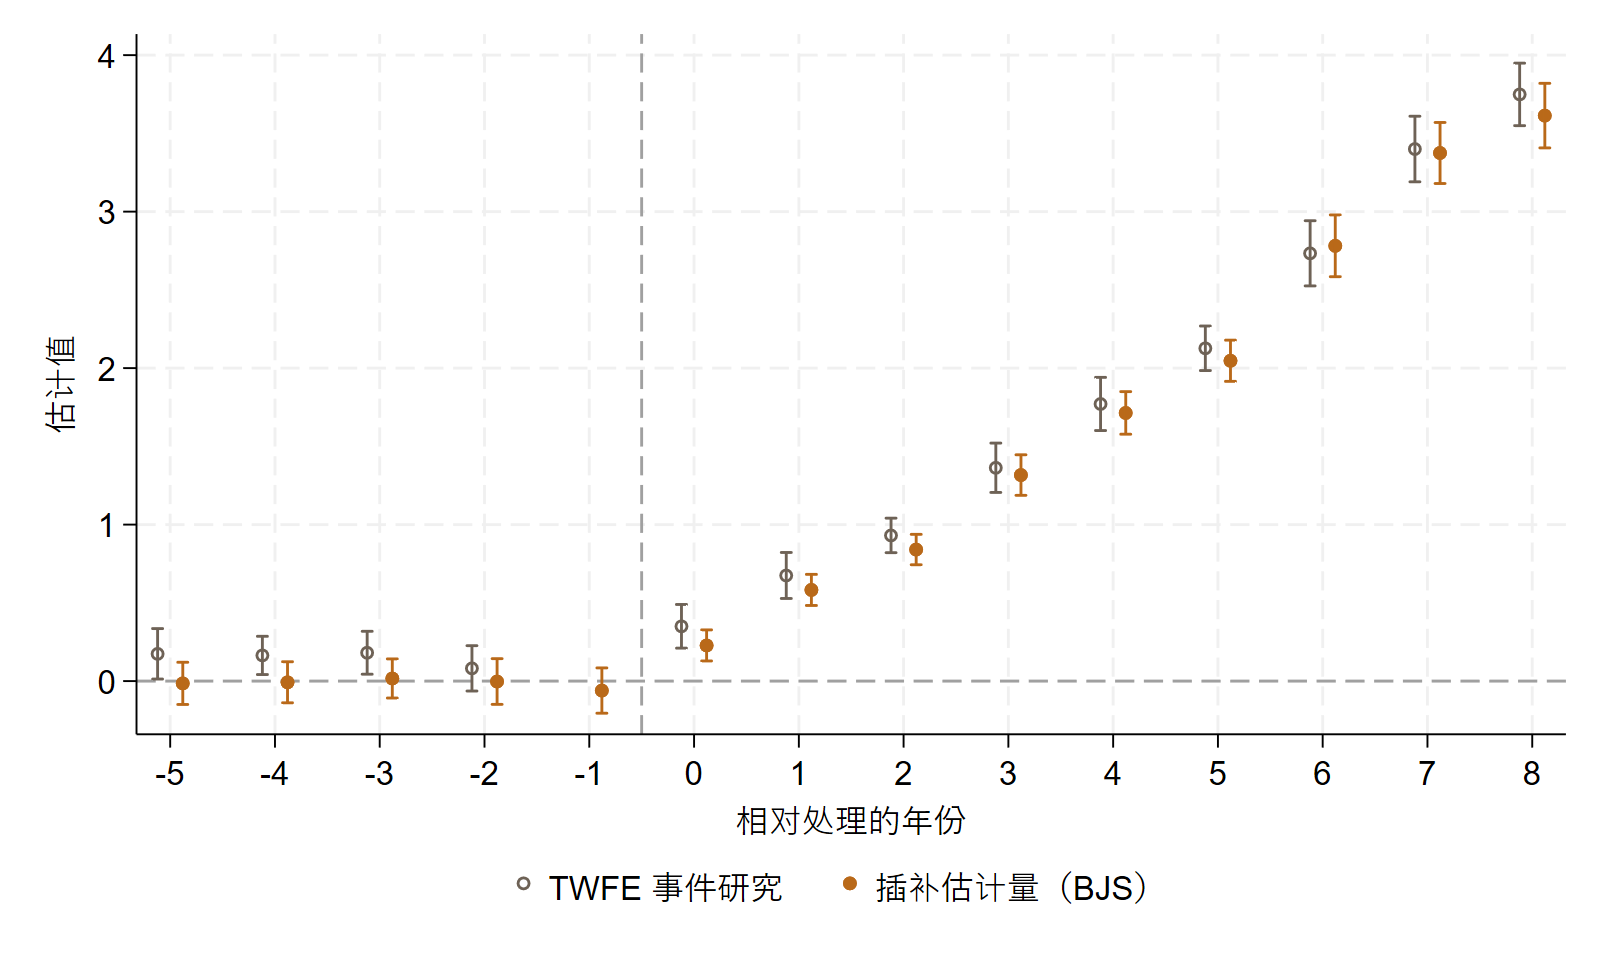
这个例子里,政策后的系数偏得不多,但政策前的假信号足以让人错误地否定平行趋势。反过来,真实存在的预趋势也可能被抵消掉。
几种异质性稳健的估计量
思路是一样的:只用“干净”的比较,不拿已经受处理的个体当对照;先估计细分的处理效应,再按明确的权重加总。
Callaway and Sant'Anna(2021):先估计每个批次 在每个年份 的效应
表示对照组,可以选“从未处理”或“尚未处理”的个体,基期固定为该批次处理前一年 。然后按需要加总成总体 ATT、按相对时间的动态效应、按批次或按日历年的效应。有协变量时用 Sant'Anna and Zhao(2020)的双重稳健估计。Stata 命令是 csdid;Stata 18 起官方的 xthdidregress 也提供了这类估计。
Sun and Abraham(2021):在事件研究回归里让每个批次各有一套相对时间系数,对照组用从未处理组或最后一批,再按各批次在该相对时间上的样本占比加权(只算这一期能观测到的批次)。命令是 eventstudyinteract。这个例子里它的政策后系数和 csdid(从未处理组作对照)完全相同。
Borusyak, Jaravel and Spiess(2024)的插补估计量:只用未处理的观测(从未处理的,加上尚未处理的)估计 ,据此插补处理观测的反事实 ,差值 就是逐个观测的效应估计,再按需要平均。它用上了所有未处理观测,在误差同方差、互不相关的条件下是最有效的线性无偏估计量,实际中标准误也往往最小。代价是假设更强:未处理的潜在结果在整个样本期都满足平行趋势(而不只是处理前一年到处理后),并且没有预期效应。预趋势检验也单独在未处理观测上做,不会被处理后的效应污染。命令是 did_imputation。Wooldridge(2025)提出的扩展 TWFE(Stata 里对应 Rios-Avila 写的 jwdid)在平衡面板、没有协变量时,点估计和插补估计量相同。
de Chaisemartin and D'Haultfœuille:比较“刚改变处理状态的个体”和“处理状态还没变的个体”,适用范围更广,处理可以中途退出(比如政策取消),也可以不是 0/1。命令是 did_multiplegt_dyn。注意它的 Effect_1 是处理状态第一次改变的那一期;在这里这种 0/1、处理后不退出的设定下,就对应别的命令里的第 0 期。处理路径更复杂时,要按它自己对“暴露期”的定义来读。
模拟数据上的总体 ATT(真实值 1.325):
| 方法 | Stata 命令 | 估计值 | 标准误 |
|---|---|---|---|
| 双向固定效应 | reghdfe |
0.508 | 0.040 |
| Callaway–Sant'Anna(对照:从未处理) | csdid,estat simple |
1.439 | 0.066 |
| Stata 18 官方(回归调整) | xthdidregress ra |
1.439 | 0.066 |
| 插补估计量 | did_imputation |
1.382 | 0.037 |
| 扩展 TWFE | jwdid,estat simple |
1.382 | 0.037 |
这一次抽样里两个稳健估计量都比 1.325 略高。重复 200 次的结果更能说明问题:
| 方法 | 200 次的平均 | 200 次的标准差 |
|---|---|---|
| 双向固定效应 | 0.460 | 0.035 |
| Callaway–Sant'Anna | 1.331 | 0.062 |
| 插补估计量 | 1.331 | 0.038 |
两个稳健估计量都没有偏差,插补估计量的波动更小,这和上面说的“用上所有未处理观测、更有效率”一致。
动态效应(只列前 6 期):
| 相对处理的年份 | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| 真实值 | 0.25 | 0.50 | 0.75 | 1.30 | 1.63 | 1.95 |
csdid |
0.33 | 0.63 | 0.87 | 1.41 | 1.78 | 2.10 |
did_imputation |
0.23 | 0.58 | 0.84 | 1.32 | 1.71 | 2.05 |
did_multiplegt_dyn |
0.28 | 0.63 | 0.89 | 1.38 | 1.77 | — |
代码
先装依赖。新版 reghdfe 需要 ftools 和 require,jwdid 需要 hdfe,did_multiplegt_dyn 需要 gtools,eventstudyinteract 需要 avar,而 avar 又要用 ivreg2 自带的 Mata 库:
foreach p in ftools require reghdfe bacondecomp drdid csdid did_imputation ///
             ranktest ivreg2 avar eventstudyinteract hdfe jwdid gtools        ///
             did_multiplegt_dyn event_plot {
    ssc install `p', replace
}
几个命令对“从未处理”的编码要求不同:csdid、jwdid 要求处理时点变量取 0,did_imputation、eventstudyinteract 要求取缺失。
gen gvar = cond(g == ., 0, g)            // csdid、jwdid 用
gen never = (g == .)                     // eventstudyinteract 用

* Callaway–Sant'Anna
csdid y, ivar(id) time(year) gvar(gvar)            // 对照:从未处理
csdid y, ivar(id) time(year) gvar(gvar) notyet     // 对照:尚未处理
estat simple
estat event, window(-5 8)

* 插补估计量
did_imputation y id year g, autosample
did_imputation y id year g, horizons(0/8) pretrends(5) autosample
estimates store bjs

* Sun–Abraham:先生成相对时间虚拟变量,-1 期为基期
gen rel = year - g
forvalues j = 9(-1)2 {
    gen lead`j' = (rel == -`j')
}
forvalues j = 0/8 {
    gen lag`j' = (rel == `j')
}
eventstudyinteract y lead* lag*, cohort(g) control_cohort(never) absorb(i.id i.year) vce(cluster id)

* 扩展 TWFE
jwdid y, ivar(id) tvar(year) gvar(gvar)
estat simple

* de Chaisemartin–D'Haultfœuille
did_multiplegt_dyn y id year D, effects(5) placebo(3) cluster(id)

* Stata 18 官方命令
xthdidregress ra (y) (D), group(id)
estat aggregation
上面那张对比图是用 event_plot 画的:
reghdfe y lead* lag*, absorb(id year) vce(cluster id)
estimates store twfe_es
event_plot twfe_es bjs, stub_lag(lag# tau#) stub_lead(lead# pre#) together ///
    plottype(scatter) perturb(-0.12 0.12) trimlead(5) noautolegend        ///
    graph_opt(xtitle("相对处理的年份") ytitle("估计值") xlabel(-5(1)8)      ///
              legend(order(1 "TWFE 事件研究" 3 "插补估计量") rows(1) position(6)))
eventstudyinteract 如果报 struct ms_vcvorthog undefined,是 avar 没找到 ivreg2 的 Mata 库:先确认装了 ivreg2,再重启 Stata,或者运行一次 mata: mata mlib index。
我的做法
- 先看处理时点的分布:每年新进入处理的个体有多少,有没有从未处理组。只有一个处理时点的,上一篇的方法就够了。
- TWFE 和至少一种稳健估计量都报告。两者差得多时,用
bacondecomp看看权重落在哪里。 - 事件研究图用稳健估计量来画。
- 想清楚对照组:从未处理组和处理组可比吗?没有从未处理组时只能用尚未处理组,最后一批进入之后的年份就估计不了。
- 政策会取消、或者处理不是 0/1 的,用
did_multiplegt_dyn。
中文文献里,刘冲、沙学康和张妍(2022)对这几类方法做了系统的梳理,也有模拟比较,可以对照着读。
参考文献
- Borusyak, K., Jaravel, X., & Spiess, J. (2024). Revisiting event-study designs: Robust and efficient estimation. Review of Economic Studies, 91(6), 3253–3285.
- Callaway, B., & Sant'Anna, P. H. C. (2021). Difference-in-differences with multiple time periods. Journal of Econometrics, 225(2), 200–230.
- de Chaisemartin, C., & D'Haultfœuille, X. (2020). Two-way fixed effects estimators with heterogeneous treatment effects. American Economic Review, 110(9), 2964–2996.
- de Chaisemartin, C., & D'Haultfœuille, X. (2026). Difference-in-differences estimators of intertemporal treatment effects. Review of Economics and Statistics, 108(4), 863–880.
- Goodman-Bacon, A. (2021). Difference-in-differences with variation in treatment timing. Journal of Econometrics, 225(2), 254–277.
- Roth, J., Sant'Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What's trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244.
- Sant'Anna, P. H. C., & Zhao, J. (2020). Doubly robust difference-in-differences estimators. Journal of Econometrics, 219(1), 101–122.
- Sun, L., & Abraham, S. (2021). Estimating dynamic treatment effects in event studies with heterogeneous treatment effects. Journal of Econometrics, 225(2), 175–199.
- Wooldridge, J. M. (2025). Two-way fixed effects, the two-way Mundlak regression, and difference-in-differences estimators. Empirical Economics, 69(5), 2545–2587.
- 刘冲, 沙学康, 张妍. (2022). 交错双重差分:处理效应异质性与估计方法选择. 数量经济技术经济研究, 39(9), 177–204.