合成控制法:权重、置换检验与合成 DID
很多政策只落在一个地方:一个省的改革试点,一座城市的限购,一个国家的新法案。DID 需要一个和处理组“平行”的对照组,单个地区往往找不到。合成控制法(synthetic control method, SCM)的思路是:用若干没受影响的地区加权平均,拼出一个政策前走势和处理地区尽量一致的“合成地区”,把它在政策后的走势当作反事实(Abadie and Gardeazabal, 2003;Abadie, Diamond and Hainmueller, 2010)。国内比较早的应用之一是刘甲炎和范子英(2013)对房产税试点的评估。
这篇用的模拟数据:31 个地区,1995–2024 年,地区 1 从 2015 年起受政策影响。效应逐年扩大,第一年 ,之后每年再多 ,十年平均 。结果由两个共同因子驱动,一个是线性增长的趋势,一个是周期波动,各地区对它们的反应(载荷)不同。地区 1 的潜在参数(水平 和两个载荷)取增长载荷最高的三个对照地区的加权平均,所以它本来就比对照组的平均长得快,但对照池里存在一个能复制它系统性部分的组合。能观测到的地区特征 、 带着独立的误差,每年的结果也有随机冲击,这部分是复制不了的。
set seed 20261002
set obs 31
gen id = _n
gen alpha = rnormal()
gen mu1 = runiform(0, 2)                     // 对增长趋势的载荷
gen mu2 = runiform(0, 2)                     // 对周期波动的载荷
* 地区 1 = 增长载荷最高的三个对照地区按 0.5、0.3、0.2 加权
egen rk = rank(-mu1) if id > 1, unique
foreach v in alpha mu1 mu2 {
    quietly sum `v' if rk == 1
    local a1 = r(mean)
    quietly sum `v' if rk == 2
    local a2 = r(mean)
    quietly sum `v' if rk == 3
    local a3 = r(mean)
    replace `v' = 0.5*`a1' + 0.3*`a2' + 0.2*`a3' if id == 1
}
gen x1 = mu1 + 0.3*rnormal()                 // 能观测到的地区特征,和载荷相关
gen x2 = mu2 + 0.3*rnormal()
expand 30
bysort id: gen year = 1994 + _n
gen t = year - 1995
gen y = alpha + 0.1*t + 0.08*t*mu1 + sin(t/3)*mu2 + 0.2*rnormal()
gen treated = (id == 1 & year >= 2015)
gen tau = cond(treated, -0.3*(year - 2014), 0)
replace y = y + tau
权重从哪里来
设地区 1 在 期之后受处理,其余 个地区是对照池。合成控制给每个对照地区一个权重 ,要求非负、加总为 1。权重的选法是让合成地区在一组“预测变量”上尽量接近地区 1:
是地区 1 的预测变量(政策前若干年的结果、地区特征), 是对照地区的对应矩阵。 是一个对角的加权矩阵,决定衡量“接近”时各个预测变量占多大分量。Stata 的 synth 默认用一种基于回归的数据驱动方法定 ,速度快;加 nested 选项则在所有对角半正定矩阵里搜索,使政策前各年结果的均方预测误差最小,慢一些,拟合通常更好;也可以用 customV() 自己指定。政策效应的估计值就是实际值减合成值:
这个差值要能解释成因果效应,还需要几个条件:没有预期效应,对照地区没受溢出影响,同期没有别的冲击只打在地区 1 上,最后一节会再说。
它比 DID 灵活的地方在于:DID 的差分只能去掉不随时间变化的差异,要求处理组和对照组的趋势平行;合成控制去匹配的是政策前的整条路径。如果结果由若干共同因子驱动(线性因子模型),各地区对因子的反应不同,那么在随机冲击不大、政策前足够长、拟合误差又小的情况下,政策前拟合得好,就说明合成地区在这些看不见的载荷上也接近地区 1(Abadie, Diamond and Hainmueller, 2010)。这是有条件的:政策前太短、噪声太大时,好的拟合也可能只是贴合了噪声。
权重非负、加总为 1,意味着在所选的预测变量上,合成值是对照地区的加权平均,不会外推到对照地区的范围之外。权重往往只落在少数几个地区上,便于检查;但权重不一定唯一,不要把某个地区分到的权重当成它对结果的“贡献”来解读。
反过来,要检查地区 1 是否落在(或者接近)对照地区在这些预测变量上的“凸包”里。如果它是最极端的那一个(比如收入最高的省份),加权平均往往拼不出来,政策前就拟合不好,结论也就站不住。它离凸包多远、拟合差到什么程度还能接受,要结合预测变量的平衡表和政策前路径来判断(Abadie, 2021)。
模拟:DID 和合成控制
先看双向固定效应 DID:估计为 ,真实值是 。政策前,“地区 1 减对照平均”的差距每年扩大 0.069,平行趋势明显不成立。按地区聚类的标准误还给出了 的“显著”,但只有一个处理地区时,聚类稳健标准误本身就不可靠(Conley and Taber, 2011)。
合成控制用两个地区特征加上 1995、1999、2003、2007、2011、2014 年的结果做预测变量:
tsset id year
synth y x1 x2 y(1995) y(1999) y(2003) y(2007) y(2011) y(2014), ///
    trunit(1) trperiod(2015) keep(synth_1) replace
权重落在三个地区上:地区 10 占 0.51,地区 12 占 0.40,地区 28 占 0.09,其余都是 0。政策前的均方根预测误差(RMSPE)是 0.238,和噪声的标准差 0.2 差不多。政策后十年的平均差距是 。
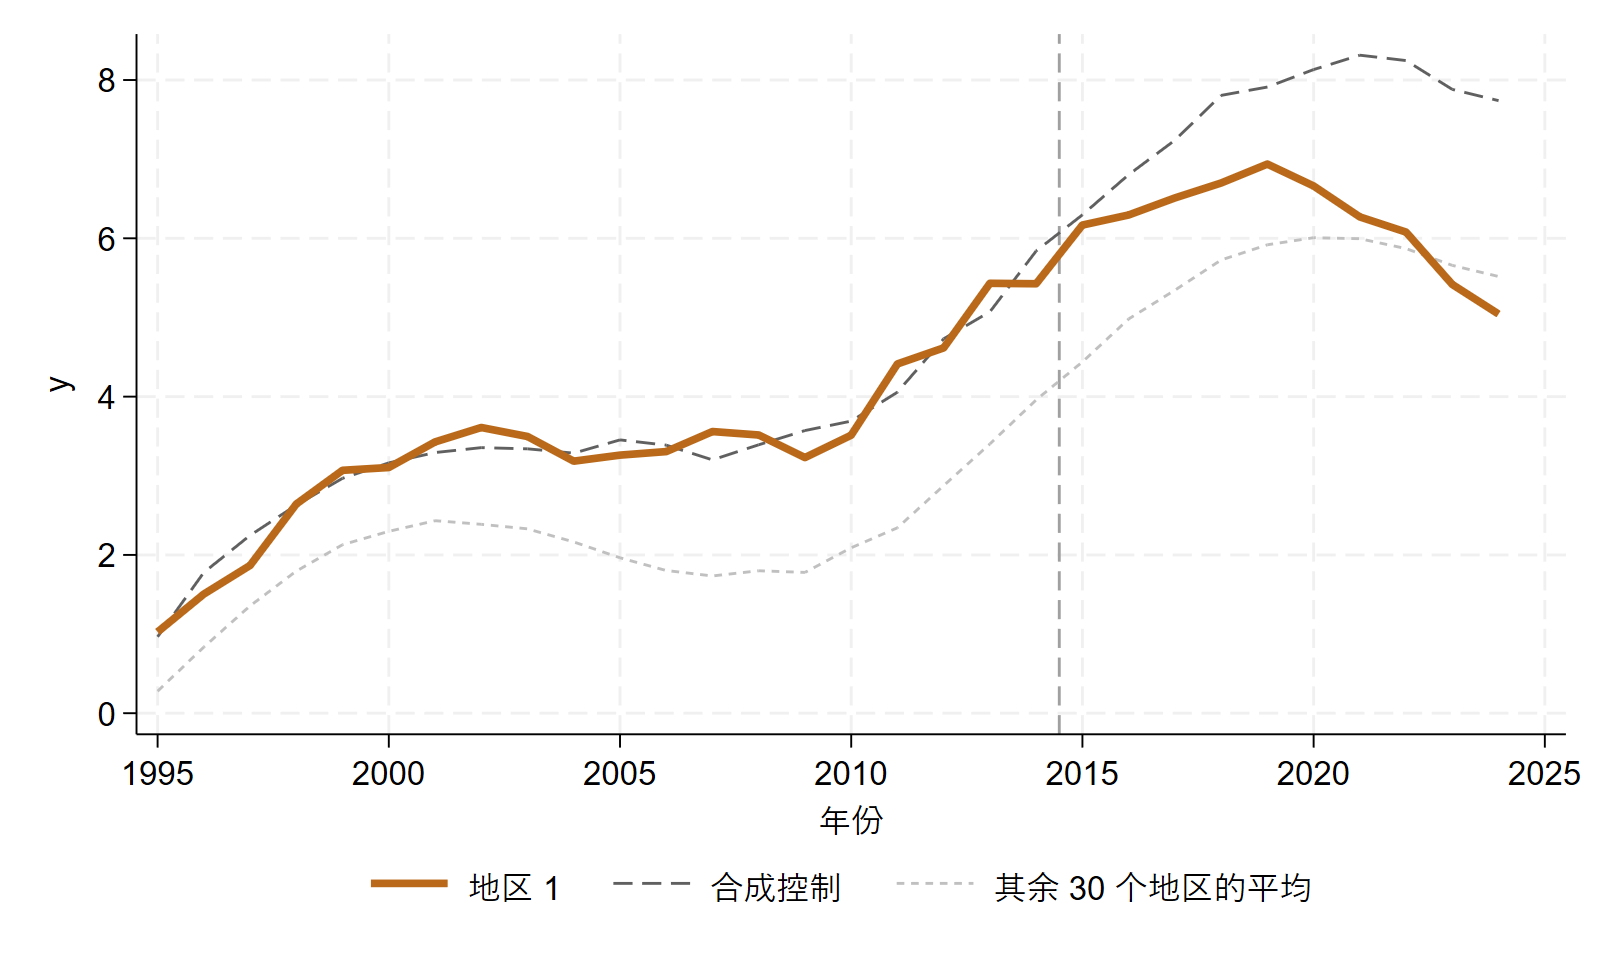
离 还差一点。噪声、带误差的地区特征、只有 20 年的政策前数据,都会让合成地区在载荷上配不准。比如 2014 年合成值比实际高了 0.41。预测变量的选法也有影响:把 1995–2014 年每年的结果都放进去,默认的优化给出了很分散的权重,政策前 RMSPE 升到 0.50,估计 ;用 nested 选项让优化更彻底,估计 ,RMSPE 0.232。Kaul et al.(2022)指出,在标准的合成控制里,如果把全部政策前结果都放进预测变量、又用数据驱动的方法选 ,额外加进去的地区特征会被赋予 0 或接近 0 的权重,等于不起作用。预测变量怎么选没有标准答案,但要事先定好,不能试到结果“好看”为止。
推断:置换检验
只有一个处理地区,不能直接用常规的回归标准误或聚类标准误。Abadie, Diamond and Hainmueller(2010)的办法是置换:把每个对照地区都假装成处理地区做一遍合成控制,对照池里去掉真正的处理地区,看地区 1 的结果在这些“安慰剂”里排第几。比较时常用“政策后 RMSPE ÷ 政策前 RMSPE”,这样政策前拟合得差的地区不会因为差距本来就大而占便宜。
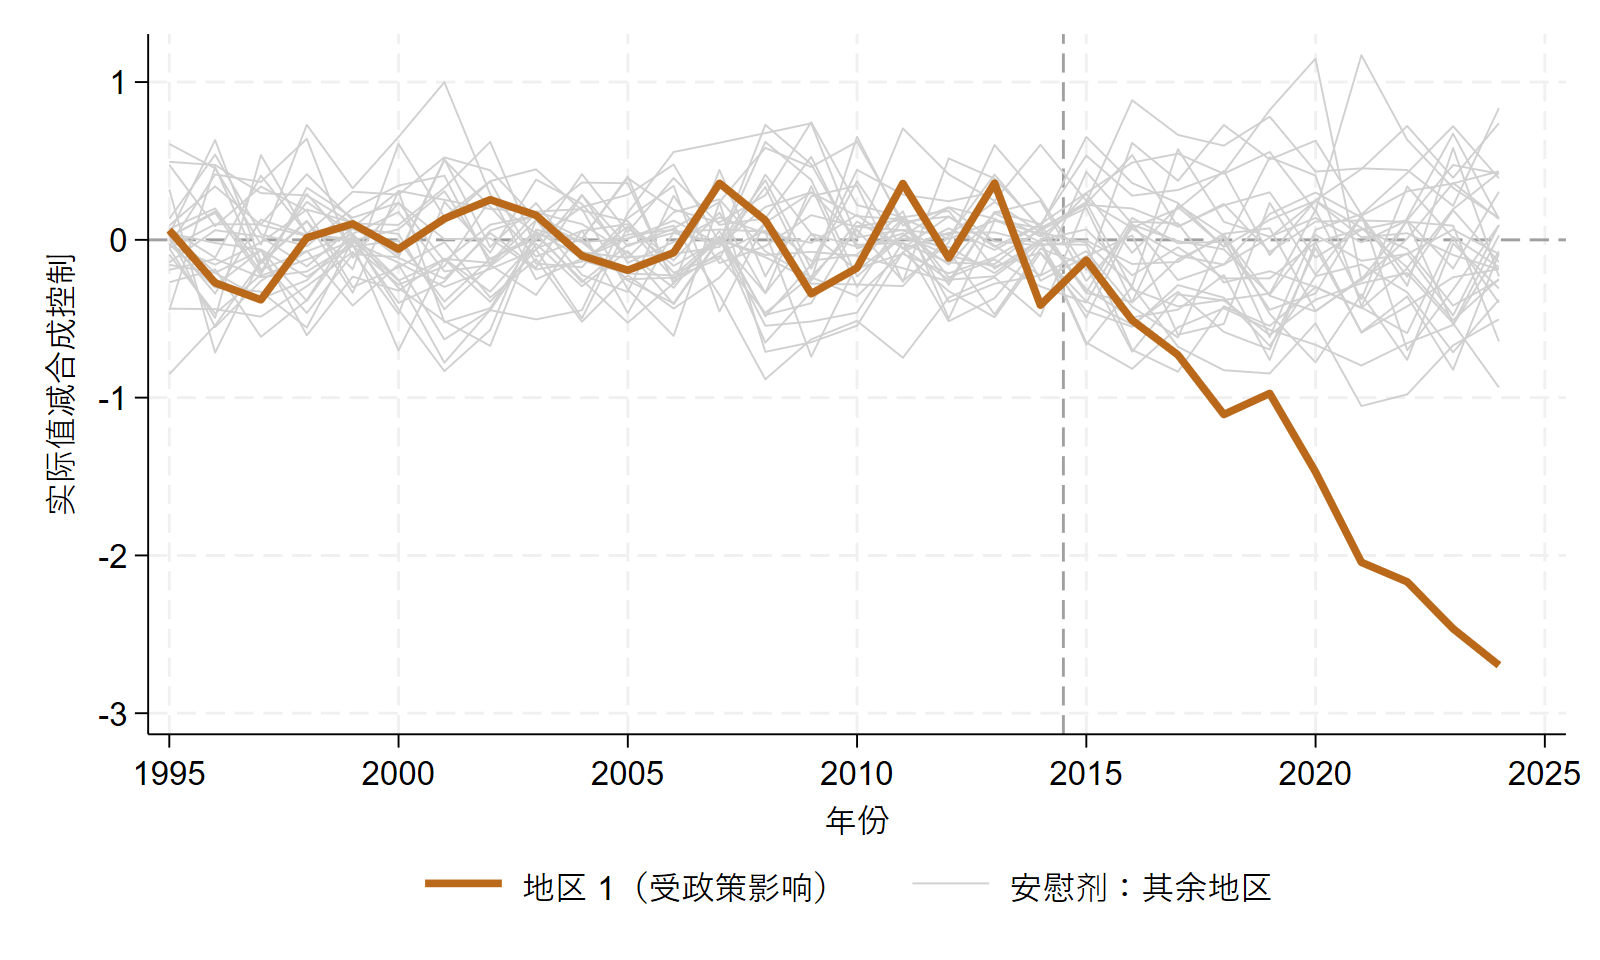
地区 1 的比值是 6.95,在 31 个地区里最大,第二名是 4.25。把地区 1 自己也算进去排名,,这也是 31 个地区时能得到的最小 p 值。对照地区少时,这个检验的分辨率很有限。这个 p 值的含义是:在“政策对哪个地区都没有效应”的原假设下,如果政策落在任何一个地区的可能性都一样,地区 1 的结果有多极端。观测数据里政策并不是随机分配的,所以它更像一种有参照的排名,而不是严格的随机化推断。另外,RMSPE 比值只看差距的大小,不看方向,检验的不是“效应为负”。
synth_runner(Galiani and Quistorff, 2017)把这套流程自动化了。它报告的 pval_joint_post_std 是“比值不小于处理地区的安慰剂所占比例”,这里是 0:分母只算 30 个安慰剂,也不包括处理地区自己。这是它自己的算法,和上面把处理地区算进去的 1/31 不是同一个数,报告时要写清楚用的是哪种。
另外两个常做的稳健性检验:
- 时间安慰剂:只用 2015 年以前的数据,假装政策在 2008 年实施(Abadie, Diamond and Hainmueller, 2015 用过这种把政策时间往前挪的检验),2008–2014 年的平均差距是 ,接近 0。
- 去掉一个对照:去掉权重最大的地区 10 重新合成,估计为 ,结论不变。
合成 DID
Arkhangelsky et al.(2021)的合成 DID(synthetic difference-in-differences)把两种方法结合起来:像合成控制一样给对照地区加权,也给政策前的各个年份加权,同时保留个体和时间固定效应,所以允许处理地区和合成对照之间有一个固定的水平差。它的单位权重带惩罚项,通常比纯合成控制分散。Stata 命令是 sdid(Clarke et al., 2024),只有一个处理单位时用置换法(vce(placebo))算标准误:把“处理”随机分给对照单位、重复估计,看估计值有多分散。它要求对照单位比处理单位多,还假定各单位误差的方差相同;置信区间用的是正态近似,重复次数(这里 200 次)本身也带来一点随机误差。
同一份模拟数据上,sdid 包里的三种方法(真实值 )。注意 sdid 只用结果变量本身,不用 、,它的 method(sc) 也有自己的预处理和权重规则,所以和上面 synth 的结果并不是同一设定下的比较:
| 方法 | 估计值 | 标准误 | 95% 置信区间 |
|---|---|---|---|
合成 DID(method(sdid)) |
0.317 | [, ] | |
合成控制(method(sc)) |
0.476 | [, ] | |
DID(method(did)) |
1.070 | [, 1.487] |
这里合成 DID 反而偏得比较多。看它的权重就明白:单位权重很分散,最大的只有 0.12,地区 10 只分到 0.03;时间权重集中在 2014 年(0.81)和 2001 年(0.19)。地区 1 是对照池里增长最快的那一类,分散的权重拼不出它的增长趋势,估计就被拉向了 DID。Arkhangelsky et al.(2021)基于真实数据的模拟里,合成 DID 的表现往往好于另外两种,所以这只说明没有哪种方法在所有数据上都占优。几种方法都报告,并分别看它们政策前的拟合(sdid 的 graph 选项可以画出来)。
什么时候要小心
- 处理地区太“出格”:落在对照地区的凸包之外时,政策前就拟合不好。可以考虑允许水平差异的方法(合成 DID),或者用回归来修正残余差距的 augmented SCM(Ben-Michael, Feller and Rothstein, 2021)。
- 政策前太短、拟合不完美:拟合看上去不错,可能只是碰巧贴合了噪声;拟合不完美时,合成控制也可能有偏差(Ferman and Pinto, 2021)。
- 对照池不干净:受同一政策影响、或者受溢出效应影响的地区要排除,否则合成出来的反事实本身就被污染了。
- 同期还有别的冲击只打在处理地区上:合成控制分不开这两件事。
- 多个处理地区:可以逐个做再平均(
synth_runner支持多个处理单位、不同的处理时间),或者用合成 DID。 - 只凭一张“实际值与合成值”的对比图不足以支持结论;推断要按设计选用置换检验、时间安慰剂、留出一段政策前数据检验拟合等方法,不能套用回归的标准误。
代码
ssc install synth, replace
ssc install sdid, replace
* synth_runner 在 SSC 上装不到,从作者的 GitHub 装
net install synth_runner, from("https://raw.github.com/bquistorff/synth_runner/master/") replace

tsset id year
* 优化更彻底(慢一些):加 nested;synth 会打印一长串优化过程,可以加 quietly
synth y x1 x2 y(1995) y(1999) y(2003) y(2007) y(2011) y(2014), trunit(1) trperiod(2015) nested

* 置换检验:自动把每个对照地区都当一次处理地区
synth_runner y x1 x2 y(1995) y(1999) y(2003) y(2007) y(2011) y(2014), ///
    trunit(1) trperiod(2015) gen_vars
display e(pval_joint_post_std)
effect_graphs
pval_graphs

* 合成 DID:一个处理单位时用置换法算标准误
sdid y id year treated, vce(placebo) reps(200) seed(2026)
sdid y id year treated, vce(placebo) reps(200) seed(2026) method(sc)
sdid y id year treated, vce(placebo) reps(200) seed(2026) method(did)
想看清置换检验每一步在做什么,可以自己写循环。下面这段先算出每个地区的差距和比值,再画出上面那张安慰剂图:
tempname res
postfile `res' unit year gap using placebo_gaps, replace
forvalues j = 1/31 {
    local donors ""
    forvalues k = 2/31 {
        if `k' != `j' local donors "`donors' `k'"      // 对照池里去掉地区 1 和自己
    }
    quietly synth y x1 x2 y(1995) y(1999) y(2003) y(2007) y(2011) y(2014), ///
        trunit(`j') trperiod(2015) counit(`donors')
    matrix g = e(Y_treated) - e(Y_synthetic)
    forvalues r = 1/30 {
        post `res' (`j') (1994 + `r') (g[`r', 1])
    }
}
postclose `res'

use placebo_gaps, clear
gen post = year >= 2015
gen g2 = gap^2
collapse (mean) mspe = g2, by(unit post)
reshape wide mspe, i(unit) j(post)
gen ratio = sqrt(mspe1/mspe0)                // 政策后 RMSPE ÷ 政策前 RMSPE
gsort -ratio
list unit ratio in 1/5

* 作图:去掉政策前 MSPE 超过地区 1 五倍的安慰剂,只是为了看得清楚
save placebo_ratios, replace
use placebo_gaps, clear
merge m:1 unit using placebo_ratios, keepusing(mspe0) nogen
sum mspe0 if unit == 1
gen keepline = mspe0 <= 5*r(mean)
sort unit year
twoway (line gap year if unit != 1 & keepline, connect(L) lcolor(gs13))    ///
       (line gap year if unit == 1, lcolor("185 105 25") lwidth(thick)),     ///
       xline(2014.5, lpattern(dash)) yline(0)                                ///
       legend(order(2 "地区 1" 1 "安慰剂")) xtitle("年份") ytitle("实际值减合成控制")
入门读物推荐 Abadie(2021)那篇综述,什么时候能用、数据要满足什么条件、怎么报告,都讲得很清楚。
参考文献
- Abadie, A. (2021). Using synthetic controls: Feasibility, data requirements, and methodological aspects. Journal of Economic Literature, 59(2), 391–425.
- Abadie, A., Diamond, A., & Hainmueller, J. (2010). Synthetic control methods for comparative case studies: Estimating the effect of California's tobacco control program. Journal of the American Statistical Association, 105(490), 493–505.
- Abadie, A., Diamond, A., & Hainmueller, J. (2015). Comparative politics and the synthetic control method. American Journal of Political Science, 59(2), 495–510.
- Abadie, A., & Gardeazabal, J. (2003). The economic costs of conflict: A case study of the Basque Country. American Economic Review, 93(1), 113–132.
- Arkhangelsky, D., Athey, S., Hirshberg, D. A., Imbens, G. W., & Wager, S. (2021). Synthetic difference-in-differences. American Economic Review, 111(12), 4088–4118.
- Ben-Michael, E., Feller, A., & Rothstein, J. (2021). The augmented synthetic control method. Journal of the American Statistical Association, 116(536), 1789–1803.
- Clarke, D., Pailañir, D., Athey, S., & Imbens, G. (2024). On synthetic difference-in-differences and related estimation methods in Stata. Stata Journal, 24(4), 557–598.
- Conley, T. G., & Taber, C. R. (2011). Inference with “difference in differences” with a small number of policy changes. Review of Economics and Statistics, 93(1), 113–125.
- Ferman, B., & Pinto, C. (2021). Synthetic controls with imperfect pretreatment fit. Quantitative Economics, 12(4), 1197–1221.
- Galiani, S., & Quistorff, B. (2017). The synth_runner package: Utilities to automate synthetic control estimation using synth. Stata Journal, 17(4), 834–849.
- Kaul, A., Klößner, S., Pfeifer, G., & Schieler, M. (2022). Standard synthetic control methods: The case of using all preintervention outcomes together with covariates. Journal of Business & Economic Statistics, 40(3), 1362–1376.
- 刘甲炎, 范子英. (2013). 中国房产税试点的效果评估:基于合成控制法的研究. 世界经济, 36(11), 117–135.